Einführung
Oct 8, 2026Das hier ist nur eine Einführung. Hier geht’s nur um Abstraktion und noch nicht so richtig um Inhalte. :)
Um diskrete Mathematik betreiben zu können, müssen wir es irgendwie schaffen reale Bestände so weit zu abstrahieren, bis nur noch die Struktur übrig ist die wir untersuchen wollen. Das ganze können wir am Beispiel eines Straßennetzes illustrieren..
0.1 - Modellierung
In diesem Kapitel geht es darum, den Schritt aus der echten Welt in die Abstraktion zu verstehen – nicht Graphentheorie zu erklären :)
Angenommen die Boom-Town Cottbus möchte im Umland sechs neue Siedlungen erschließen und muss dafür die sechs Siedlungsmittelpunkte mit einem möglichst kurzen Straßennetz erschließen. Dabei ist die Distanz zwischen den Siedlungsmittelpunkten für jedes Siedlungspaar bekannt. Das die Siedlungen auch an Cottbus angeschlossen werden müssten lassen wir hier einfach mal außer acht tho. Um dieses Problem zu modellieren gehen wir wiefolgt vor:
- Wir erschließen das praktische Problem und überführen es in
- ein abstraktes Modell. Das abstrakte Modell enthält nur noch die Eigenschaften, die wir zum lösen des Problems brauchen. Das abstrakte Modell wir zum
- transformierten Modell, wenn wir das Problem auf unserem abstrakten Modell lösen. Dabei können mehrere Schritte nötig sein. Anschließend können wir das transformierte Modell
- auf das reale Problem anwenden.
Dieses Kochrezept wenden wir jetzt mal auf unser Problem mit dem Straßennetz an, denn: der Stadtrat war so nett und hat uns die Distanz zwischen den Siedlungsmittelpunkten einfach auf einer Karte eingetragen. Und ja, wir nehmen an das die Siedlungen A, E, F, G, I & P heißen. Frag nicht, das Beispiel kommt aus der Vorlesung. Die Karte ist jetzt hier leider nicht existent, die Werte dafür schon:
| / | A | E | F | F | I | P |
|---|---|---|---|---|---|---|
| A | - | 120 | 147 | 142 | 147 | 81 |
| E | 120 | - | 132 | 42 | 157 | 45 |
| F | 147 | 132 | - | 108 | 66 | 105 |
| G | 142 | 42 | 108 | - | 168 | 61 |
| I | 107 | 157 | 66 | 168 | - | 112 |
| P | 81 | 45 | 105 | 61 | 142 | - |
Ach ja: die Angaben sind in km und hinterfragt auch nicht, wie Siedlungen im Umkreis einer gar nicht mal so großen Großstadt über 100km auseinanderliegen können.. Anyways, in dem Moment in dem wir die Distanzwerte von der Karte in die Tabelle übernehmen, überführen wir gleichzeitig das reale Problem in ein Abstraktes Modell. Denn jetzt haben wir als Datengrundlage wirklich nur noch die Distanzen, über denen wir das Problem lösen sollten. Ein möglicher Ansatz das gesuchte Netz zu finden ist die Tabelle in einen gewichteten Graphen zu transformieren. Der könnte dann in etwa so aussehen, nur in etwas ordentlicher bitte
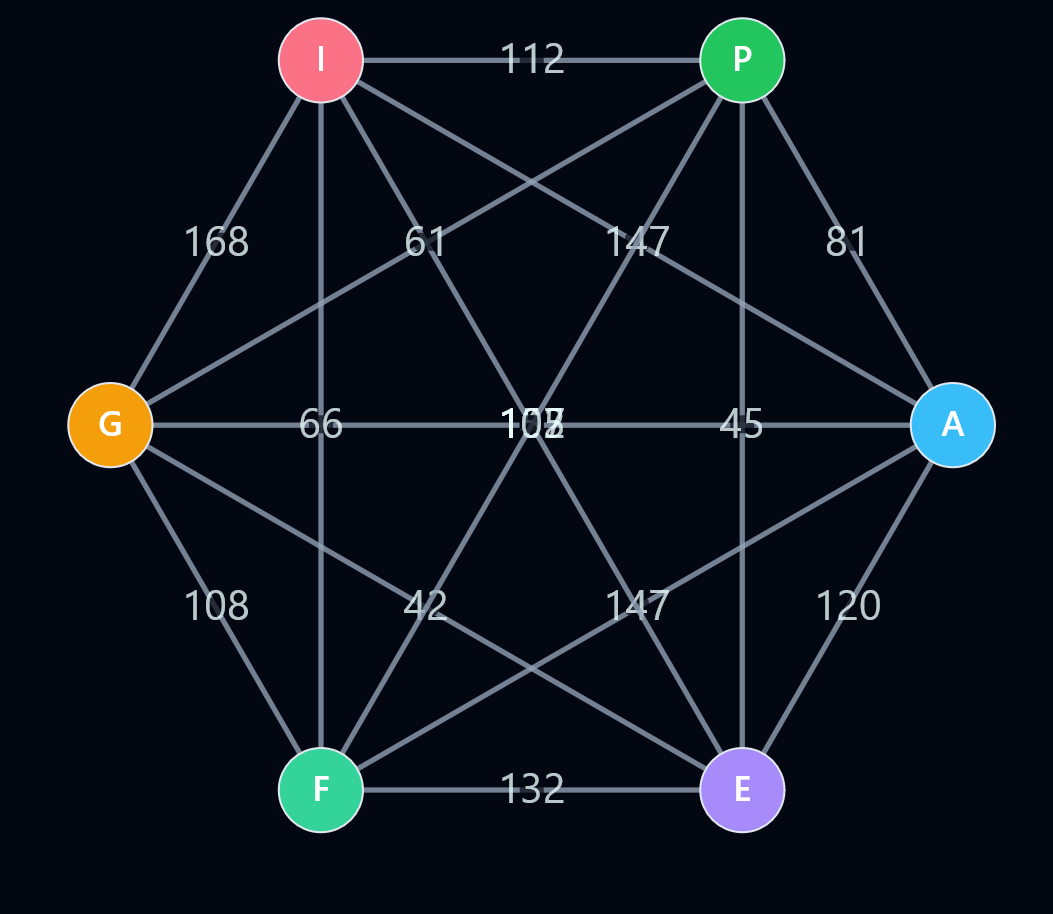
Kurze Begriffklärung:
Ein Graph besteht aus
- Knoten/Vertecies: die entsprechen hier den Siedlungen,
- Kanten/Edges: die entsprechen hier den Straßen zwischen den Siedlungen, und
- Gewichten/Weights an den Kanten: die entsprechen hier den Distanzen der Straßen zwischen den Siedlungen.
Um das abstrakte Modell in das transformierte Modell zu überführen müssen wir jetzt nur noch das Strßennetz mit den geringsten Gewichten/Distanzen zwischen den Kanten finden. Dafür gibt es neben Brute-Force (also dem brutalen Probieren aller möglichen Kombinationen) und dem geschickten Kombinieren (der insgesamt leichtesten Kanten), einen relativ eleganten Algorithmus der ebenfalls in der Vorlesung vorgestellt wurde: der Prim-Algorithmus.
Prim-Algorithmus
Sei ein beliebiger gewichteter und ungerichteter Graph gegeben:
- wähle einen beliebigen Knoten als Startpunkt auf dem Graph und die leichteste, von dem Knoten ausgehende, Kante. Verbinde den, über diese Kante erreichten, Knoten mit dem Startknoten,
- suche nicht erschlossenen Knoten mit der günstigsten Kante, zu einem bereits erschlossenen Knoten,
- wiederhole Schritt 2 bis alle Knoten erschlossen sind.
Wir wählen jetzt “G” als Startknoten aus und betrachten als erstes die Gewichte der Kanten, die an “G” angrenzen:
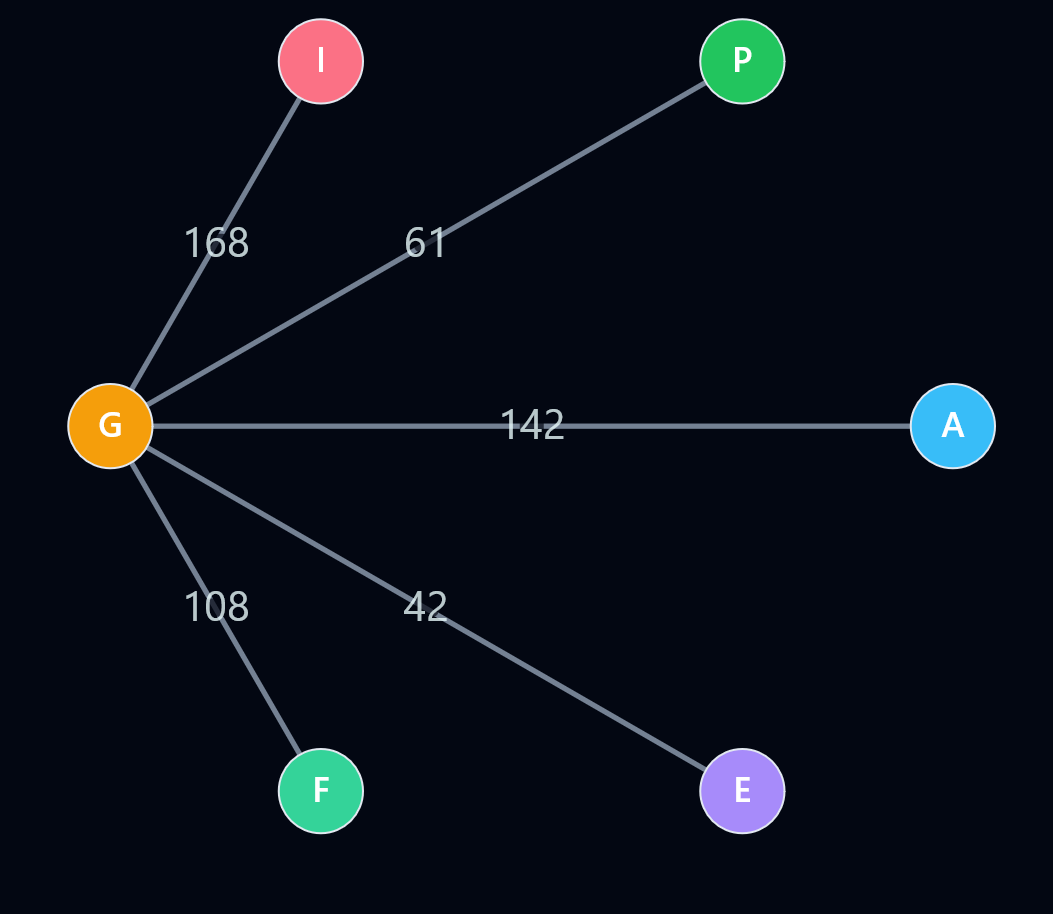
| A | E | F | G | I | P | |
|---|---|---|---|---|---|---|
| G | 147 | ==42== | 108 | - | 168 | 61 |
Offensichtlich ist die leichteste Kante hier $(G,E)=42$. Wir verbinden für unseren leichtesten Graphen also die Knoten “G” und “E” mit einer Kante.
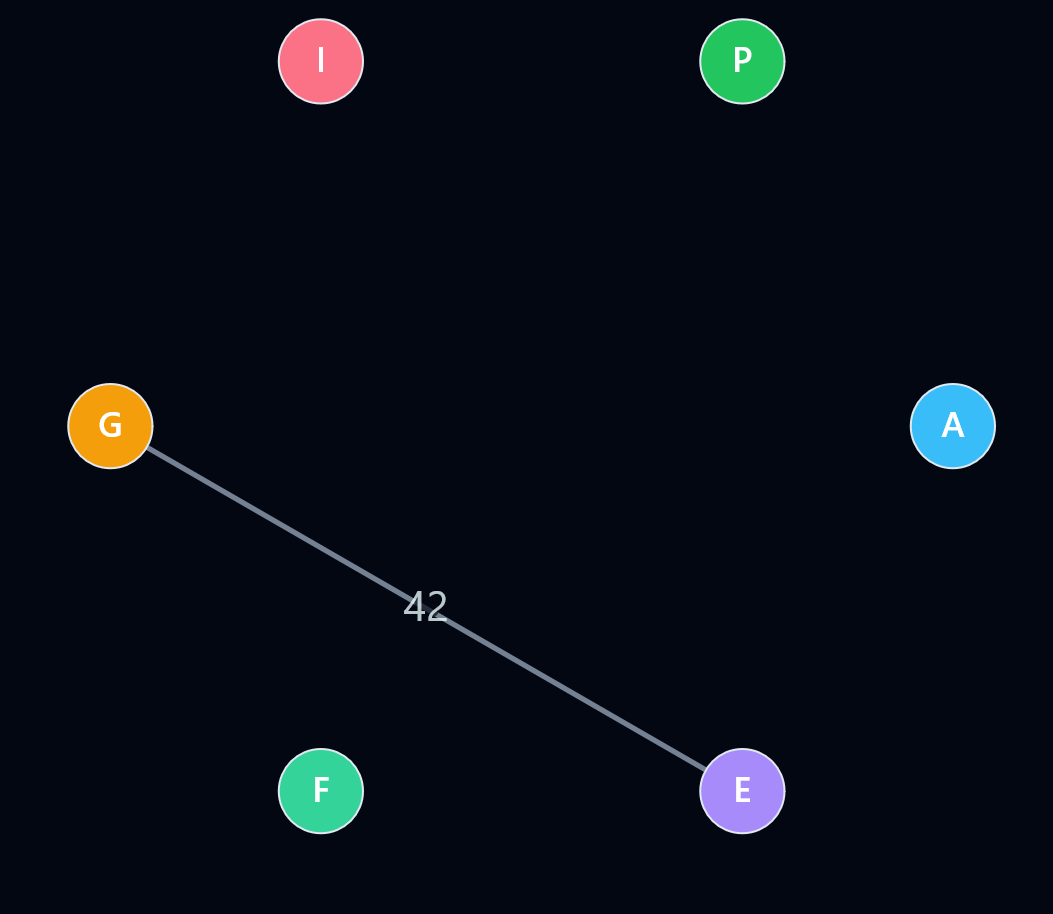
Jetzt betrachten wir wieder alle Kanten die von den erschlossenen Knoten “G” und “E” wegführen – also zu nicht erschlossenen Knoten führen. Da wir den nächsten Knoten sowohl an “G” als auch an “E” anschließen können, betrachten wir ab jetzt immer die gesamte Spalte.
| A | E | F | G | I | P | |
|---|---|---|---|---|---|---|
| G | 147 | ==42== | 108 | - | 168 | 61 |
| E | 120 | - | 132 | - | 157 | ==45== |
Die nächste Kante die wir in unseren leichtesten Graphen einbinden ist also $(E,P)=45$.
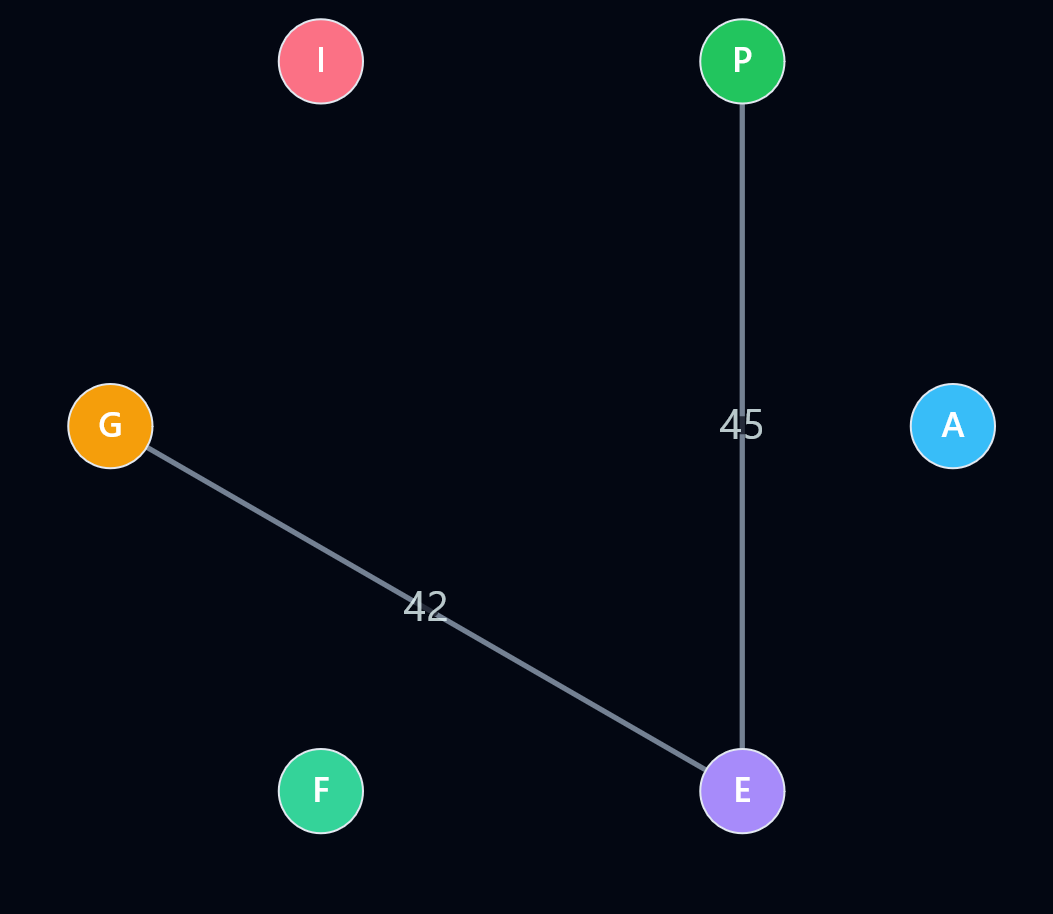
| A | E | F | G | I | P | |
|---|---|---|---|---|---|---|
| G | 147 | ==42== | 108 | - | 168 | 61 |
| E | 120 | - | 132 | - | 157 | ==45== |
| P | ==81== | - | 105 | - | 112 | - |
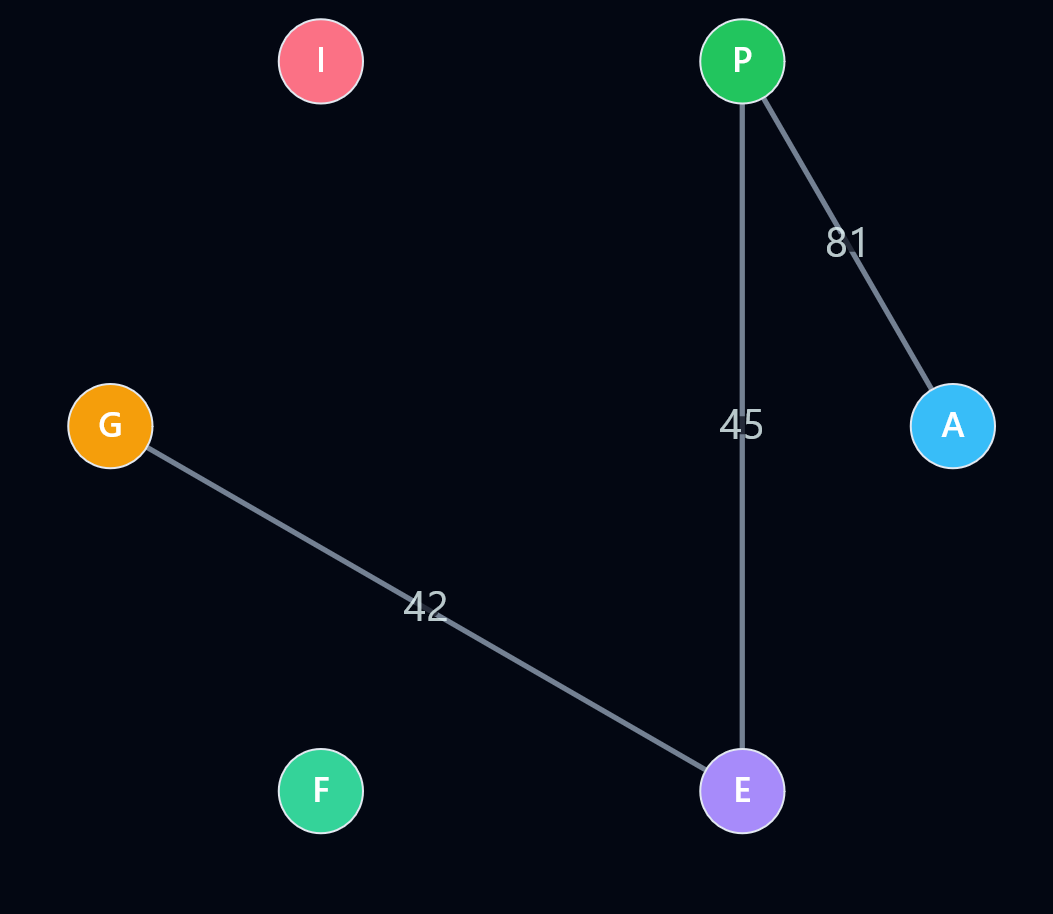
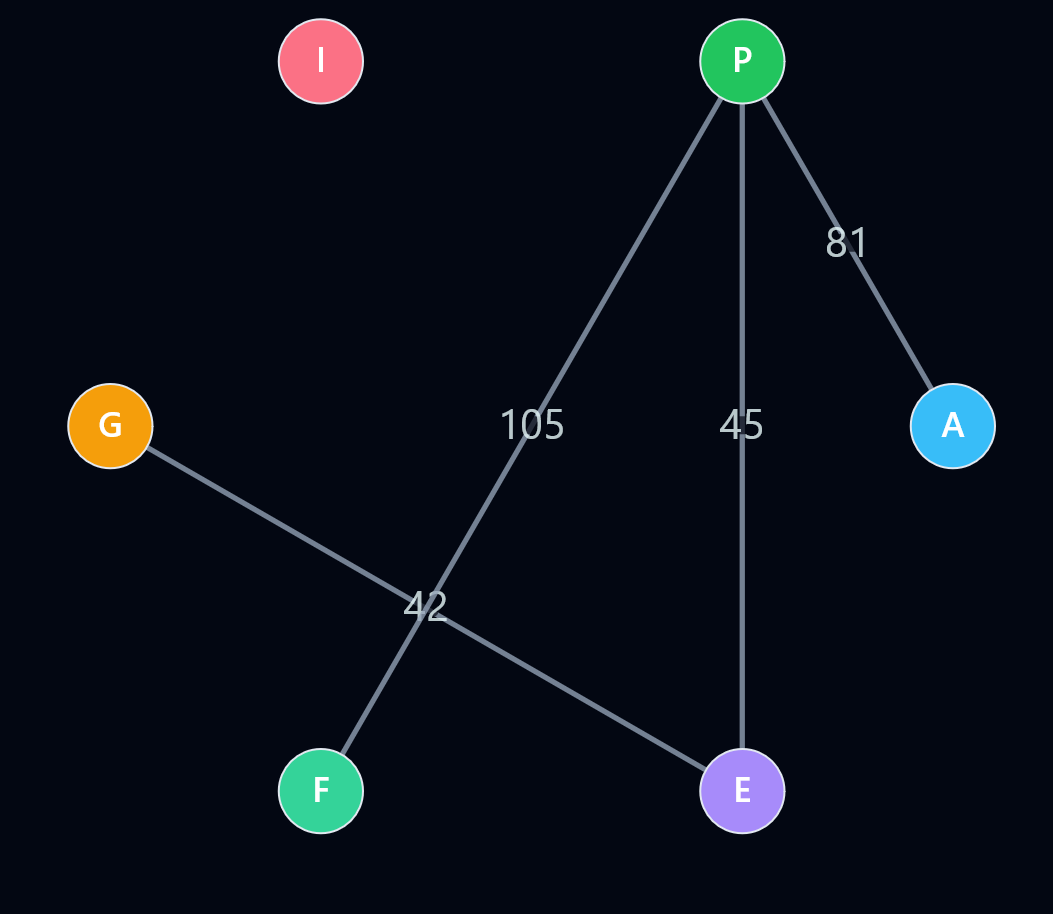
Der nächste Schritt ist etwas interessanter: Mit dem gerade erschlossenen “A” ergeben sich direkt von diesem Knoten $(A,F)=147$ oder $(A,I)=107$. Da wir aber “F” und “I” auch über alle anderen bereits erschlossenen Knoten anschließen können betrachten wir die jeweiligen Spalten.
| A | E | F | G | I | P | |
|---|---|---|---|---|---|---|
| G | 147 | ==42== | 108 | - | 168 | 61 |
| E | 120 | - | 132 | - | 157 | ==45== |
| P | ==81== | - | ==105== | - | 112 | - |
| A | - | - | 147 | - | 107 | - |
| A | E | F | G | I | P | |
|---|---|---|---|---|---|---|
| G | 147 | ==42== | 108 | - | 168 | 61 |
| E | 120 | - | 132 | - | 157 | ==45== |
| P | ==81== | - | ==105== | - | 112 | - |
| A | - | - | 147 | - | 107 | - |
| F | - | - | - | - | ==66== | - |
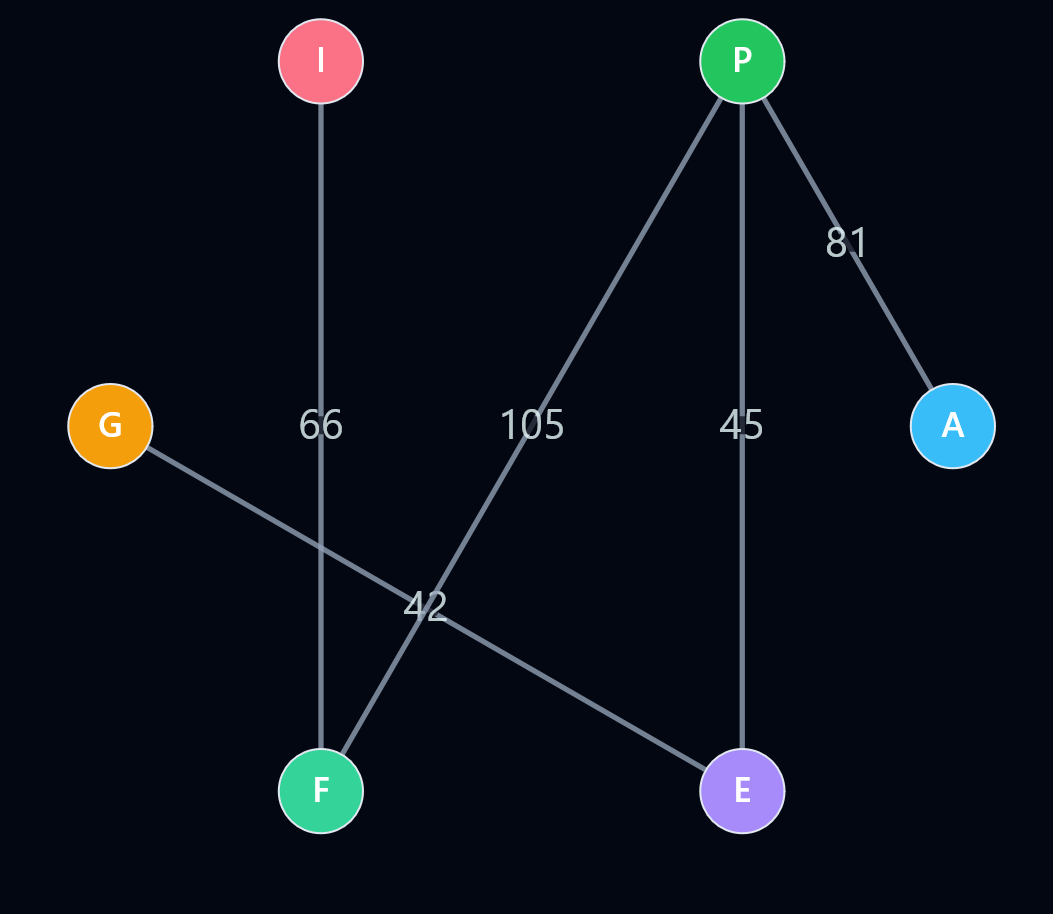
Jetzt haben wir einen Teilgraph der, spoiler, tatsächlich der leichteste ist. Wie man das genau zeigt kommt apperently später im Semester. Bis dahin bleiben erstmal die
Leitfragen
- Stimmt spezifisch dieser Algorithmus?
- Kann ich einen allgemeinen Beweis formulieren?
- Existiert ein schnellerer Algorithmus?
0.2 - Pseudocode
In der Mathematik für ITler dreht sich vieles um Algorithmen. Algorithmen sind dabei eigentlich nur eine Folge von präzisen Anweisungen die befolgt wird, um eine Eingabe in eine Ausgabe umzuwandeln. Jetzt gibt’s da nur ein kleines Problem: menschliche Sprache ist per Design nicht präzise. Um dafür zu komensieren könnte man Algorithmen einfach direkt in Code darstellen, aber so gut wie jeder hat da eine Preferenz zu Sprache und Stil. Deswegen führen wir für den Zweck dieser Veranstaltung Pseudocode ein.
Programmarker (unterstreichen)
begin
...
end
Anweisungen
- Input (unterstreichen)
Input <Variablenname>;
- Output (unterstreichen)
Output <Variablenname>;
- Zuweisung
<Variablennamen>:=Wert;
Steuerkonstrukte
- konditionell (if, then, else unterstreichen)
if Bedingung then
	Anweisung...;
else
	Anweisung;
- iterativ/for (for, to, do unterstreichen)
for <Variablenname>:=Start to End do
	Anweisung...;
- iterativ/while (while, do unterstreichen)
while Bedingung do
	Anweisung...;
Last edited: 09.10.2026